TL;DR
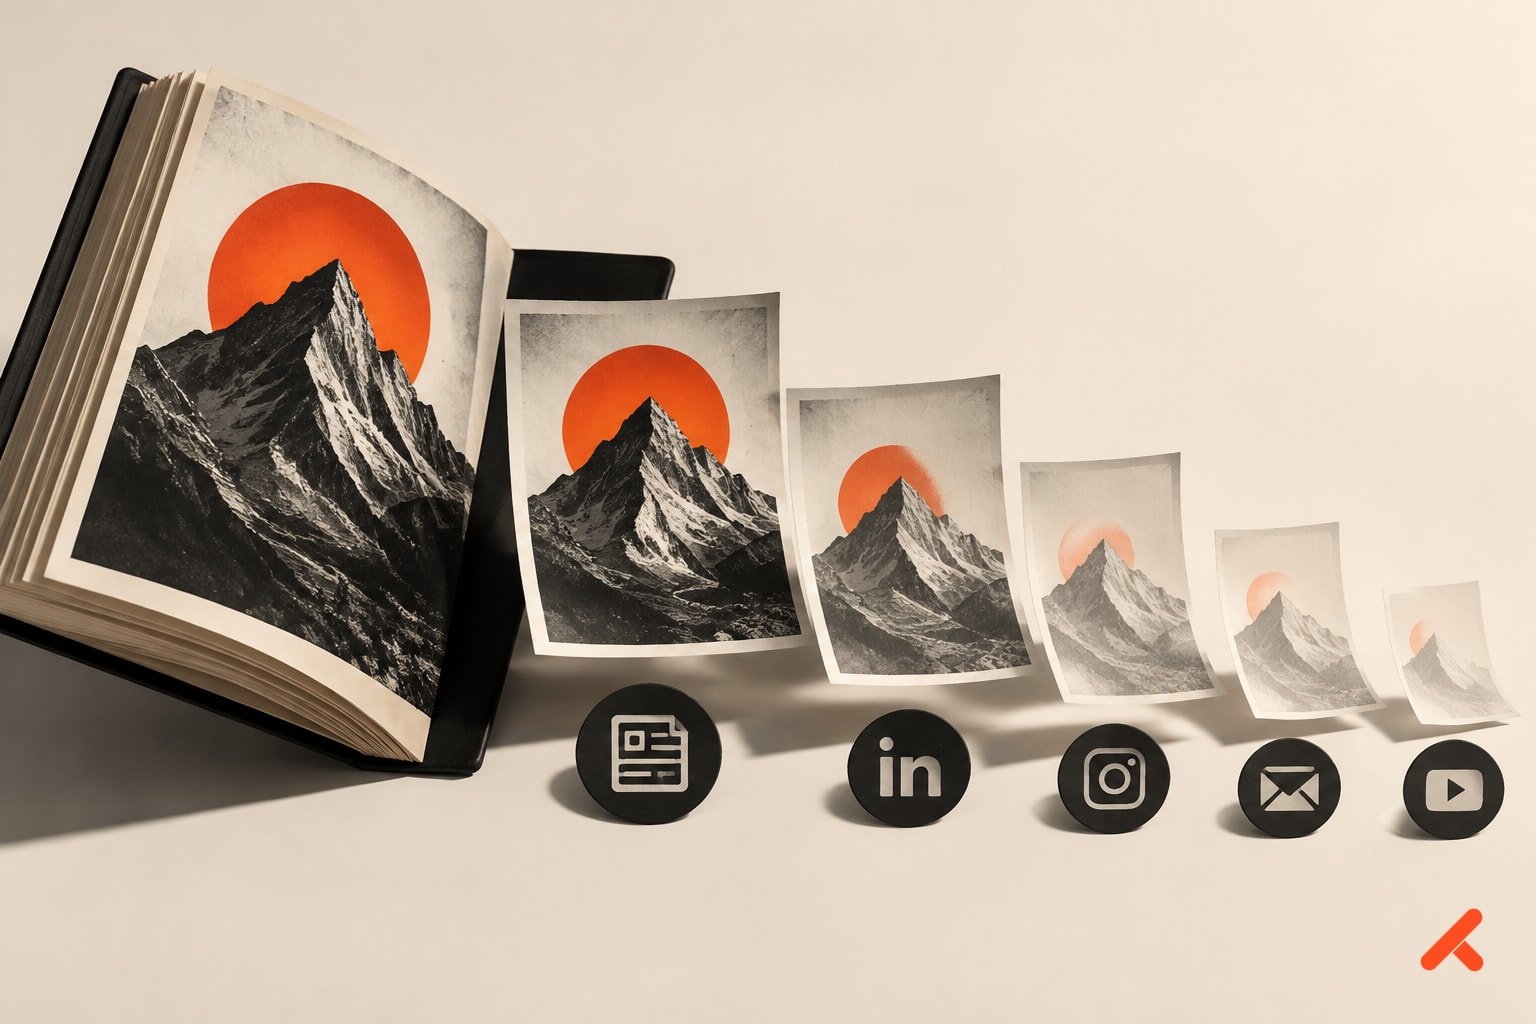
- Wenn jeder Kanal aus dem vorherigen Post gebaut wird, entsteht eine Kette aus Kopien, die mit jeder Generation an Substanz verliert.
- Der eigentliche Fehler liegt selten im Karussell, Video oder Newsletter, sondern in der Quelle, aus der alle Formate gespeist werden.
- Ein starkes Arbeitsdokument mit Recherche, eigenem Fall, Zahlen und wörtlichen Kundensätzen trägt Blog, Feed und Video gleichzeitig.
- Die gleiche Gesetzmäßigkeit zeigt sich in der aktuellen KI-Praxis: Tiefe im Ergebnis folgt der Tiefe im Input.
- Kontrolliere deshalb nicht zuerst die Formate, sondern die Herkunft Deiner letzten Beiträge.
Inhaltsverzeichnis
- Die Alltagsszene: Dein Feed wird leiser, obwohl Du mehr machst
- Die Fehleranalyse: Nicht das Format ist schuld, sondern die Quelle
- Die Gegenfolie: Einmal tief graben, dann alle Kanäle aus dem Vollen speisen
- Das Gesetz dahinter: Ergebnistiefe folgt Inputtiefe
- Die Arbeitsweise: Erst recherchieren, dann fassen, dann prüfen
Jeder Beitrag, den Du aus dem letzten Post ableitest, verliert rund ein Drittel seiner Substanz, und nach drei Kanälen bleibt nur noch die höfliche Hülle vom ursprünglichen Gedanken. Ich habe das in meinem eigenen Feed erlebt, denn dort war der Blog stark, LinkedIn las sich abgeschwächt, Instagram wiederholte denselben Satz in großer Schrift, und der Newsletter bedankte sich praktisch bei sich selbst. Die Schuld lag nicht am Format, sondern an der Quelle, denn ich hatte aus veröffentlichten, bereits gekürzten Fassungen weitergearbeitet statt aus der eigentlichen Recherche. In diesem Beitrag zeige ich Dir, wie Du diesen Kreislauf durchbrichst, einmal tief graben, ein Arbeitsdokument voller eigener Zahlen und wörtlicher Kundensätze anlegen und daraus jeden Kanal individuell speisen.
Die Alltagsszene: Dein Feed wird leiser, obwohl Du mehr machst
Unserer Einschätzung nach bemerken die meisten Solo-Selbstständigen die Verdünnung ihres Contents zuerst an der Resonanz und nicht an der Produktion, denn der Kalender ist voll, die Posts gehen raus, und trotzdem bleibt der Feed von Woche zu Woche ein bisschen leiser.
Wir beobachten das in unserer Arbeit immer wieder an demselben Muster. Da lag vor einiger Zeit ein Blogartikel, der wirklich etwas wollte, mit eigenem Gedanken, eigener Beobachtung und einer Formulierung, an der jemand länger gesessen hat, und dieser Artikel hat gezogen. Dann kam LinkedIn, und der Beitrag klang wie der Blogartikel, nur abgeschwächt, als hätte ihn jemand durch ein Sieb gegossen. Auf Instagram stand schließlich noch ein Teaser, der das Gleiche sagte, aber höflicher und kleiner.
Der Newsletter fasste das alles am Freitag noch einmal freundlich zusammen.
Vier Kanäle, viermal publiziert, und unserer Erfahrung nach hat kein einziger dieser Ableger mehr getragen als der eine starke Artikel am Anfang. Formal bleibt dabei alles korrekt, jeder Post erfüllt sein Format, aber das Eigene schmilzt mit jedem Schritt.
Die unbequeme Frage stellen wir deshalb ganz zu Beginn und nicht erst nach der Analyse, weil wir aus Erfahrung wissen, dass sie sonst zwischen den Kanälen und Formaten untergeht. Warum wird Dein Content mit jedem Kanal dünner, obwohl Du sichtbar mehr machst?
Die Fehleranalyse: Nicht das Format ist schuld, sondern die Quelle
Bei uns beginnt die Fehleranalyse mit einer unbequemen Beobachtung, denn wenn Repurposing schiefgeht, liegt es fast nie an der Konvertierung in ein neues Format. Die Übersetzung vom Newsletter zum LinkedIn-Post oder vom Post zum Karussell gelingt handwerklich meist gut, und genau dieses reibungslose Funktionieren verdeckt, wo der eigentliche Schaden entsteht. Er entsteht an der Quelle, aus der das Team weiterarbeitet. Wer aus bereits veröffentlichten Posts weitermacht, übernimmt Material, das schon gekürzt und feedtauglich komprimiert wurde, und vervielfältigt genau diese Vorlage in der nächsten Runde noch einmal. Jede Generation verliert dabei ein wenig Substanz, ohne dass es im Produktionsalltag auffällt, weil jede einzelne Fassung für sich genommen korrekt wirkt und niemand die Kette zurückverfolgt. Wir haben das bei einem eigenen Karussell erlebt, das aus einem Post entstand, der wiederum auf einem Blogartikel beruhte, und beim Vergleich aller drei Fassungen stimmte jede für sich, während die konkrete Beobachtung aus dem Artikel längst verschwunden war. Unserer Einschätzung nach liegt genau darin die Falle, denn eine Kopie von einer Kopie bleibt oft faktisch richtig und verliert deshalb unbemerkt das, was nur das Original trägt, den Kontext, die Begründung und die Stelle, an der Du als Leser spürst, dass hier jemand wirklich dabei war. Wenn Dein Content dünner wird, prüfe also zuerst die Stelle, aus der Du ihn speist.
Die Gegenfolie: Einmal tief graben, dann alle Kanäle aus dem Vollen speisen
Unserer Erfahrung nach drehen Profis die Reihenfolge um und bauen pro Thema zuerst Substanz, bevor sie auch nur ein einziges kanalfertiges Format schreiben. Diese Substanz lebt in einem Arbeitsdokument, das bei uns schlicht Fundus heißt, und darin landet alles, was später tragen muss. Die Recherche gehört dazu, ein eigener Fall, den wir selbst durchgespielt haben, Zahlen aus dem eigenen Alltag und wörtliche Kundensätze, die so klingen, wie sie gefallen sind, mit Schräge und Dialekt und allem. Erst wenn dieser Topf gefüllt ist, beginnt die eigentliche Verteilung, und dann wird es erstaunlich entspannt. Der Blog bekommt die Tiefe, also den Fall mit Kontext und Begründung, der Feed bekommt die eine Szene, die hängen bleibt, und das Video bekommt den einen Moment, in dem jemand aufstöhnt oder lacht. Der Beweis wechselt dabei nicht, nur der Ausschnitt, und genau das macht die Arbeit so viel leichter als das ewige Umschreiben. Wörtliche Kundensätze und eigene Zahlen halten wir für den belastbarsten Teil des Fundus, weil sie nachträglich glattgezogene Feedformulierungen in jeder Diskussion schlagen. Wer einmal so gearbeitet hat, merkt schnell, dass drei starke Beiträge aus einem Dokument weniger Kraft kosten als ein müder, der aus dem letzten Post abgekupfert wurde.
Das Gesetz dahinter: Ergebnistiefe folgt Inputtiefe
Die aktuellen großen KI-Modelle liefern ihre stärksten Ergebnisse genau dann, wenn jemand ihnen echte Arbeit und den vollen Kontext übergibt, statt sie mit einer knappen Anweisung und halbem Hintergrund abzuspeisen. Wer die Prompting-Praxis der letzten Monate verfolgt hat, erkennt das Muster sofort, denn die Tiefe des Ergebnisses folgt der Tiefe des Inputs, und dieses Prinzip endet nicht an der Modellgrenze. Bei uns zeigt sich das jede Woche aufs Neue, denn ein Redaktionsplan, der aus einer gründlichen Recherche heraus entsteht, trägt Texte, die auf jedem Kanal eigenständig klingen. Zieht dieselbe Redaktion dagegen weitere Fassungen aus einem dünnen Ausgangspost, entstehen nur noch dünnere Varianten davon. Unserer Einschätzung nach bekommt, wer Kanälen und Werkzeugen nur verflachtes Ausgangsmaterial gibt, die Verflachung vervielfältigt zurück, und das kanalübergreifend in bemerkenswerter Gleichförmigkeit. Fütterst du ein Modell mit fünf Seiten Recherche und einer klaren Aufgabe, bekommst du eine Fassung, die trägt, und dein Kanal arbeitet dabei nach exakt derselben Logik. Das Prinzip lässt sich bequem prüfen und arbeitet erschreckend zuverlässig. Wie viel Kontext hast du eigentlich in deinen letzten Beitrag gelegt, bevor du ihn auf deine Kanäle verteilt hast?
Die Arbeitsweise: Erst recherchieren, dann fassen, dann prüfen
Wir bei mr.timmy beginnen die Arbeitswoche mit der Recherche, und der erste Text entsteht erst, wenn diese Recherche etwas gefunden hat. Der Autopilot sammelt dafür, was Deine Zielgruppe gerade wirklich fragt, welche Einwände in Gesprächen fallen, welche Formulierungen in Kommentaren und Anfragen auftauchen, wo gerade niemand eine klare Antwort liefert. Aus diesem Material baut er inhaltliche Substanz, ein Arbeitsdokument mit echten Fragen, eigenen Zahlen und wörtlichen Sätzen, und dieses Dokument trägt die ganze Woche. Erst danach entstehen die Fassungen, und der Blogartikel nimmt die Tiefe, der Feed nimmt die Zuspitzung, und jeder Kanal bekommt eine eigene Auswahl aus demselben Fundus statt einer gekürzten Kopie des jeweils letzten Beitrags.
Vor jeder Ausgabe greift dann die Stimmenprüfung, und der Klartext-Score misst dabei, ob der Beitrag tatsächlich nach Deiner Marke klingt, nach Deinen Wörtern, Deinem Rhythmus und Deiner Haltung, und meldet zurück, wo eine Fassung in generische Marketing-Sprache abrutscht. Was die Prüfung nicht besteht, geht zurück in die Überarbeitung, bevor es irgendwo veröffentlicht wird.
Unserer Einschätzung nach gehört das Produkt an dieser Stelle nur als nächster Schritt. Wer diesen Recherche-First-Workflow nicht allein aus Tabellen und Erinnerungslisten aufbauen will, kann sich ansehen, wie mr.timmy ihn übernimmt, vom Sammeln der Zielgruppenfragen über das Arbeitsdokument bis zur Stimmenprüfung, die jeden Beitrag erst dann freigibt, wenn er wirklich nach Deiner Marke klingt.
Häufige Fragen
Ist Content-Recycling grundsätzlich schlecht?
Nein, Content-Recycling ist an sich völlig legitim, solange Du aus dem tiefen Arbeitsdokument schöpfst und nicht aus dem letzten veröffentlichten Post. Das Problem entsteht erst, wenn Du einen bereits komprimierten Beitrag als Vorlage nimmst und dessen abgespeckte Fassung noch einmal weiter verdünnst. Bei meiner eigenen Arbeit funktionieren die Kanalversionen immer dann gut, wenn sie alle direkt aus derselben dicken Recherche gebaut werden.
Worauf achte ich bei meinen letzten fünf Beiträgen?
Nimm Dir Deine letzten fünf Beiträge vor und notiere bei jedem einzelnen ehrlich, woher der Inhalt tatsächlich stammt. Die Frage, auf die es ankommt, lautet, ob der Beitrag aus einem Fundus mit Belegen, eigenen Zahlen und Fällen kommt oder nur aus dem jeweils vorherigen Post. Wenn ich diesen Check bei Kundentexten mache, zeigt sich meistens, dass ab dem dritten Beitrag nur noch Kopien von Kopien durch die Kanäle wandern.
Was gehört in ein tiefes Arbeitsdokument?
Zuerst gehört in das tiefe Arbeitsdokument die Recherche zu einer echten Frage Deiner Zielgruppe und nicht zu einem abstrakten Keyword. Dazu kommt ein eigener Fall mit Deinen eigenen Zahlen, ergänzt um ungekürzte Kundensätze aus Gesprächen oder Support-Mails. Genau diese Originale liefern später die Formulierungen, die weder eine KI noch ein Wettbewerber auf die gleiche Weise schreiben würde.
Warum hilft das auch bei KI-gestützter Produktion?
Große Sprachmodelle werden mit vollem Kontext spürbar brauchbarer, weil sie aus echtem Material arbeiten statt aus einer knappen Anweisung. Wenn ich dem Modell das ganze Arbeitsdokument mitgebe, kommen Entwürfe heraus, die nach mir klingen und echte Substanz tragen. Mit zwei Sätzen Prompt bekommst Du dagegen exakt den Durchschnittstext, den auch jeder andere Nutzer gerade erhält.
Eine Community-Diskussion, in der jemand genau diesen Arbeitsstil beschrieben hat, brachte dem Hinweis, echte Arbeit und vollen Kontext zu liefern statt Kopien zu teilen, 29 Upvotes und sieben Kommentare ein. Das klingt nach wenig, aber für einen Beitrag ohne Klick-Köder und ohne Reichweiten-Tricks ist das ein klares Signal dafür, dass Menschen Substanz erkennen und bewusst belohnen, wenn sie ihr begegnen. Wenn das bei völlig Fremden funktioniert, warum sollte es bei Deinen eigenen Lesern scheitern?
Schreibe einen Kommentar